FlashAttention
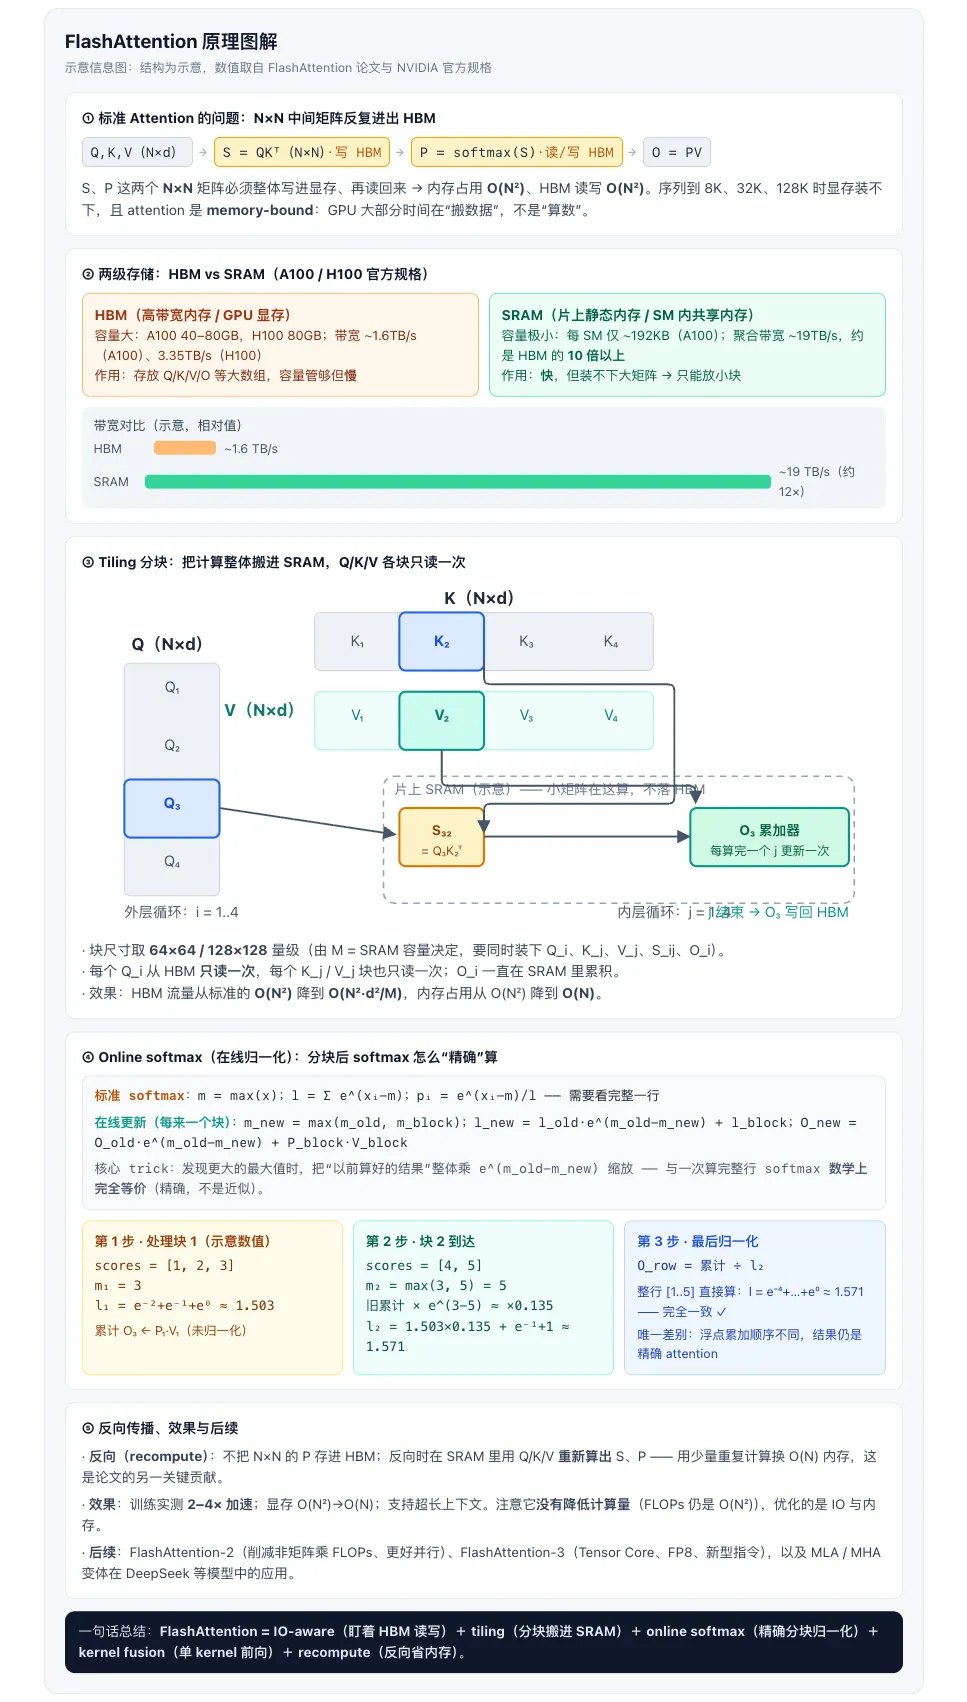
FlashAttention 没有降低 attention 的计算量(FLOPs 仍是 ),它解决的是”访存 / 内存”问题 —— 通过 IO-aware 设计,把 的中间矩阵从显存流量中拿掉,用分块(tiling)+ 在线归一化(online softmax)+ 单 kernel 融合,把显存占用从 降到 、HBM 读写从 降到约 ,实测训练 2–4× 加速。
1. 它解决的”attention 问题”是什么
标准实现中 和 都是 矩阵,必须完整写入显存再读回:内存占用 、HBM 读写 。序列一长(8K/128K token),显存放不下;而且 attention 是 memory-bound —— 计算本身很快,瓶颈在搬运数据。FlashAttention 的答案不是”近似”或”降复杂度”,而是把访存模式改成最优(IO-aware),结果仍是精确的 attention。
2. Tiling(分块)具体指什么
把 、、 切成能装进 SRAM 的小块(64×64 / 128×128 量级)。外层循环遍历 的块,内层循环遍历 的块;每一步在 SRAM 里完成:
关键收益:每个 、每个 块从 HBM 只读一次, 在 SRAM 里累积到 循环结束才写回。于是 HBM 流量从 降到 ( 为 SRAM 容量, 为头维度),内存占用 。
3. Online softmax 具体指什么
难点:softmax 的分母需要整行的最大值 和求和 ,而分块后一次只能看到一部分分数。解法是维护每行的 running max 和 running sum :每处理一个新块,若 ,就把之前累计的 和 整体乘以 缩放,再叠加新块贡献。
数学上这与一次算完整行 softmax 完全等价(只是浮点累加顺序不同),所以是”精确”而非”近似”。
4. HBM 和 SRAM 是什么、在 FA 里起什么作用
- HBM(High Bandwidth Memory):GPU 的显存(主存)。容量大(A100 40–80GB、H100 80GB),但带宽相对低(A100 ~1.6TB/s、H100 3.35TB/s)。FA 中它只承担”仓库”角色:存放 等大数组,并尽量少访问。
- SRAM(Static RAM):芯片内每个 SM 上的共享内存。容量极小(A100 每 SM 仅 ~192KB),但聚合带宽 ~19TB/s,约是 HBM 的 10 倍以上。
- 作用:FA 的全部设计就是”让数据尽量只在工作台(SRAM)上流转”—— 把小块搬进来算完再搬出去,避免反复去仓库(HBM)搬 的大矩阵。这个”用带宽高 10 倍但容量小 3 个数量级的存储替代大矩阵访存”的取舍,正是加速和显存省下来的根源。