基本概念
Attention 与 Transformer 的关系
Attention 是”机制”,Transformer 是”架构”。
Attention:
- 是一种计算相关性与加权聚合的通用机制
- 本质:Q/K 求相关性 → softmax 归一化 → 对 V 加权求和
Transformer:
- 一种编码器–解码器网络架构
- 完全基于注意力:多头自注意力 + 交叉注意力
- 配套部件:位置编码、前馈网络 FFN、残差连接、层归一化
Attention 在 Transformer 内部的三种用法:
- 自注意力 Self-Attention:编码器与解码器内部每个位置与同层全部位置交互,直接建模全局长程依赖。
- 掩码自注意力 Masked Self-Attention:解码器内部只允许看当前及之前的位置,防止信息泄漏,保证自回归生成。
- 交叉注意力 Cross-Attention:解码器 ↔ 编码器输出:Q 来自解码器,K/V 来自编码器,实现”翻译对齐”式信息抽取。
MHA、MQA、GQA、MLA
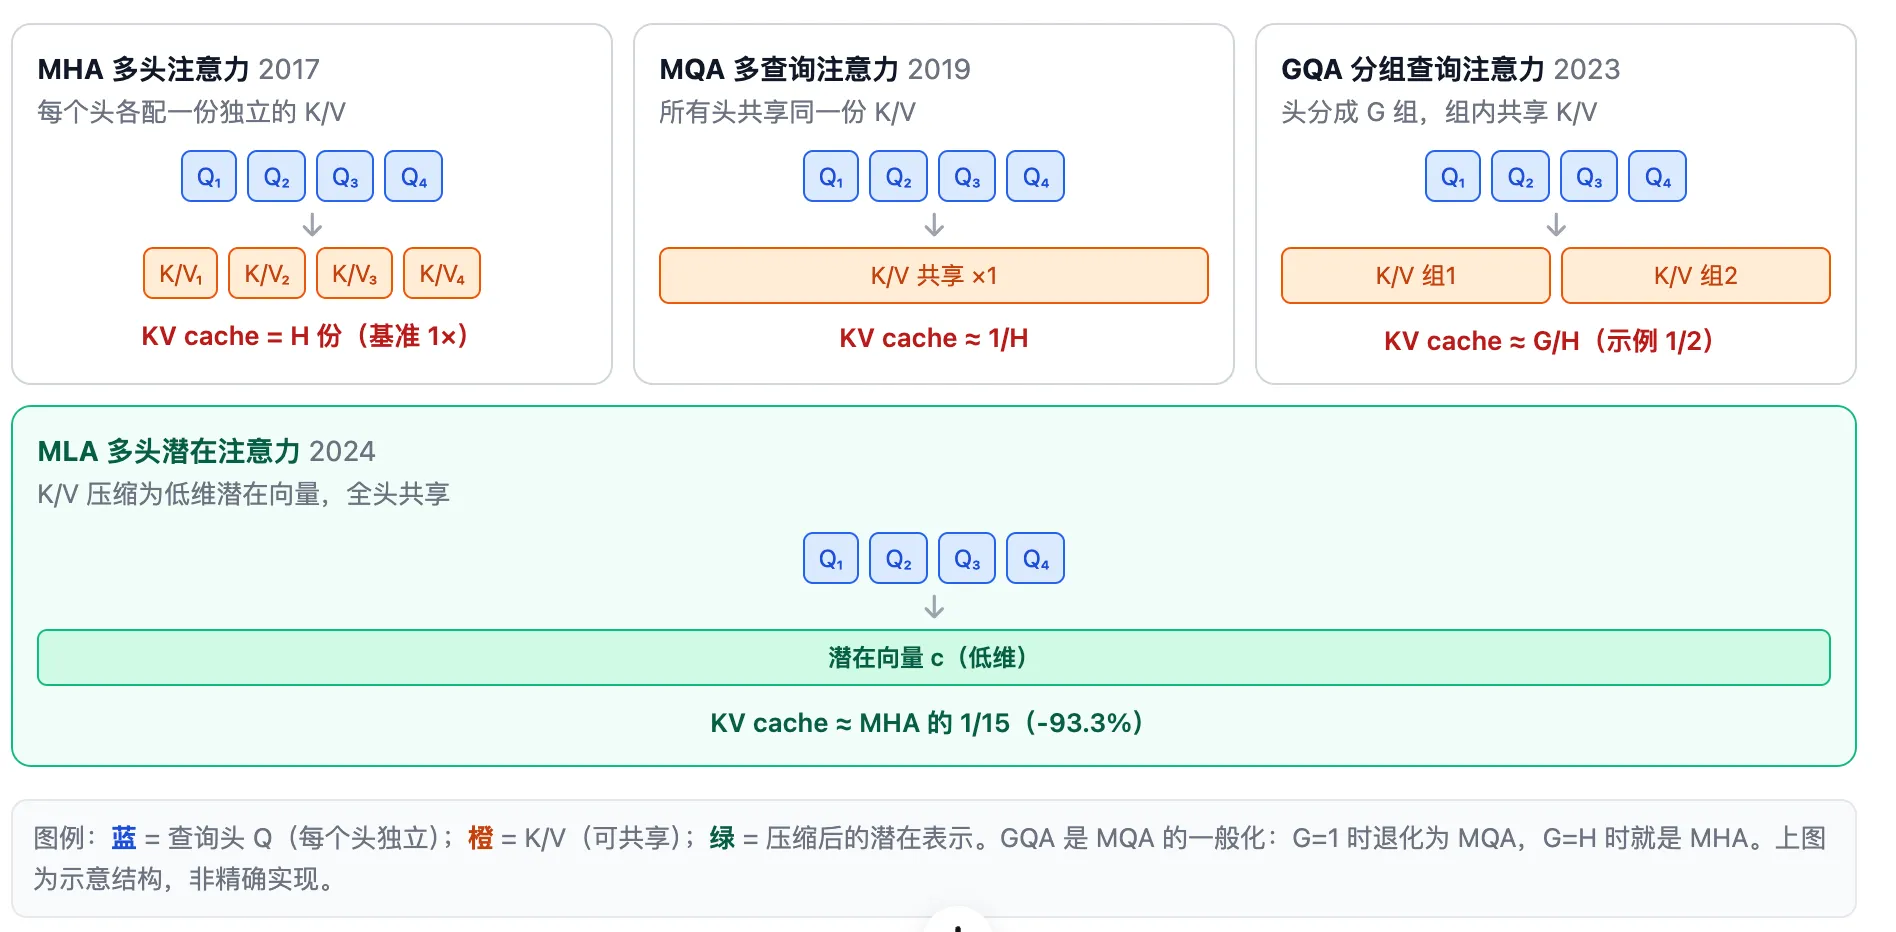
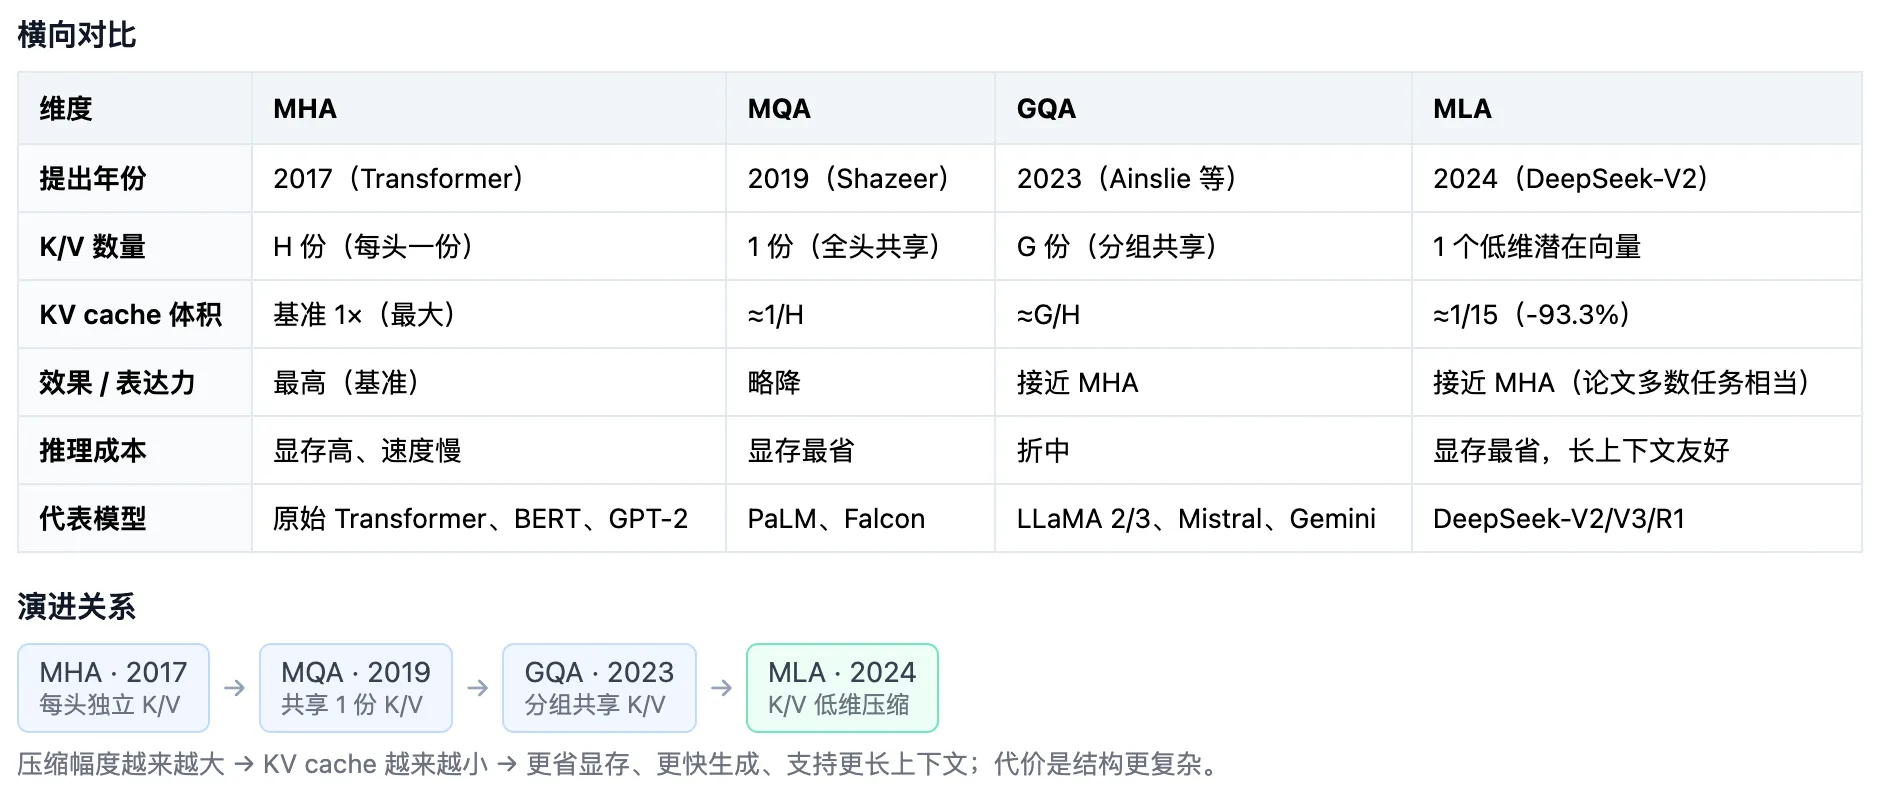
三者都是”多头注意力”的变体,本质是同一条演进主线 —— 在不明显损失效果的前提下不断压缩推理时的 KV cache(K/V 缓存):MHA 每头独立 K/V → MQA 全部头共享一份 K/V → GQA 分组共享 → MLA 把 K/V 压成低维潜在向量。
大模型自回归生成时,要把每个历史 token 的 K、V 都缓存下来(KV cache)。头越多、缓存越大,显存越贵、长上下文越难。于是有了逐代压缩方案。
横向对比:
请求链路与指标
请求过程
一次推理请求 = Prefill(一次性并行处理整个输入)→ Decode(逐 token 自回归生成)。
两个过程:Prefill 与 Decode
Prefill 预填充阶段:
- 一次性处理全部输入 token(可并行)
- 计算所有输入位置的 K/V 并写入 KV cache
- 阶段末尾产出第 1 个输出 token
- 特性:计算密集(compute-bound),耗时 输入长度 算力
Decode 解码阶段:
- 自回归循环:每步只生成 1 个新 token
- 每步都要读取全部历史 KV cache 做注意力
- 新 token 的 K/V 继续追加进缓存
- 特性:访存密集(memory-bound,带宽瓶颈),耗时 输出长度 单步延迟
两个指标:TTFT、TPOT
TTFT · Time To First Token:
- 定义:请求发出 → 收到第 1 个输出 token 的耗时
- 构成:排队等待 + Prefill 时间
TPOT · Time Per Output Token:
- 定义:生成每个输出 token 的平均耗时(约等于相邻 token 间隔)
- 构成:Decode 每步的时间(受带宽、模型规模、批大小影响)
总时延公式( 为输出 token 总数):